Post-mortem : comment un petit compteur a figé notre API
Salut tout le monde !
Le mardi 29 septembre, PDFMonkey a été lent pendant un peu moins d’une heure. Créer ou supprimer un document via l’API pouvait prendre 30 secondes ou plus, et certains d’entre vous ont sans doute eu des timeouts. On en est désolés.
La cause : un petit changement fait en mai. Il passait tous nos tests et a tourné sans souci pendant cinq mois, mais l’idée de départ était mauvaise. On tient à expliquer ce qui s’est passé, parce que c’est une erreur facile à faire.
TL;DR
- Pour suivre le nombre de documents de chaque workspace, un trigger en base de données modifiait la même ligne à chaque création ou suppression de document.
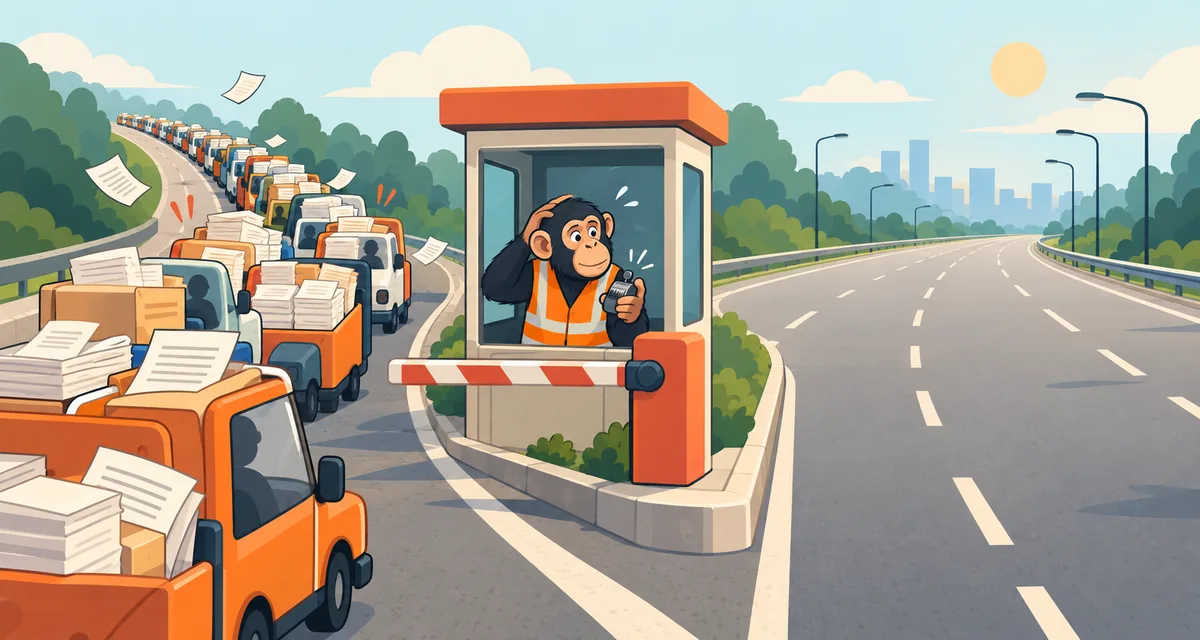
- Résultat : les documents d’un même workspace ne pouvaient être enregistrés qu’un par un. Quand un gros workspace a envoyé un lot important, plus d’une centaine de connexions à la base se sont retrouvées à faire la queue.
- On a désactivé le trigger pour que tout reparte, puis on a reconstruit le compteur autrement.
Le compteur
On avait besoin de connaître le nombre de documents de chaque workspace, et de l’obtenir rapidement. Certains workspaces contiennent près de deux millions de documents, donc les compter à chaque fois n’était pas envisageable.
En mai, on a ajouté une colonne live_documents_count à la table workspaces, et un trigger Postgres pour la tenir à jour :
CREATE TRIGGER documents_sync_workspaces_live_documents_count
AFTER INSERT OR UPDATE OR DELETE ON documents
FOR EACH ROW EXECUTE FUNCTION sync_workspaces_live_documents_count();

-- …qui, pour chaque nouveau document, exécute :
UPDATE workspaces SET live_documents_count = live_documents_count + 1
WHERE id = NEW.workspace_id;
Cette approche nous plaisait. Un trigger s’exécute quelle que soit la façon dont les données changent : depuis notre application, via une mise à jour en masse ou une requête SQL manuelle. Nos tests couvraient tous ces cas et le compteur était toujours juste.
Ce qui a coincé
Quand Postgres modifie une ligne, il la verrouille jusqu’à la fin de la transaction. Toute autre transaction qui veut modifier la même ligne doit attendre.
À cause du trigger, chaque nouveau document d’un workspace modifiait la même ligne de workspaces. Deux documents créés au même moment pour le même workspace ne pouvaient donc plus être enregistrés en parallèle : le second devait attendre le premier.
La plupart du temps, ça passait inaperçu. Un workspace classique crée quelques documents par minute, le verrou ne dure que quelques millisecondes, et personne n’attend.
Le 29 septembre, un de nos plus gros clients a envoyé un lot important de créations et de suppressions de documents. En regardant la base de données, on a trouvé 114 connexions en attente d’un verrou, toutes pour des documents de ce même workspace. L’une d’elles gardait le verrou plusieurs secondes et bloquait 81 autres à elle seule.
C’est ce qui a transformé un ralentissement en incident. Notre transaction de création de document reste ouverte pendant que l’application fait autre chose, parfois plusieurs secondes. Avec un verrou tenu aussi longtemps, la file n’a cessé de grossir, jusqu’à occuper les connexions à la base dont le reste de l’API avait besoin.
Si un jour vous devez enquêter sur un problème similaire, voici la requête qui nous a montré ce qui se passait :
SELECT pid, state, wait_event,
       now() - xact_start AS xact_age,
       cardinality(pg_blocking_pids(pid)) AS blocked_by,
       left(query, 80) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY xact_start;
On a désactivé le trigger et tout est rentré dans l’ordre immédiatement. Depuis, on a reconstruit le compteur pour qu’enregistrer un document ne modifie plus une ligne partagée.
Ce qu’on en retient
Un compteur modifié à chaque écriture devient un goulot d’étranglement. Tenir un total à jour ressemble à une façon d’accélérer les lectures, mais ça oblige chaque écriture à passer par la même ligne. Pas de problème avec peu de trafic, beaucoup plus risqué pour tout ce qu’un client peut faire en masse.
On a vérifié que c’était juste, pas que ça tenait la charge. Nos tests contrôlaient le compteur après chaque type de modification, mais n’en lançaient jamais deux en même temps. Et notre environnement de staging ne voit jamais un trafic pareil.
Les transactions longues aggravent beaucoup les verrous. Un verrou tenu quelques millisecondes passe inaperçu. Tenu plusieurs secondes, il devient un problème.
Tous les chiffres n’ont pas besoin d’être exacts en temps réel. Ce compteur aurait pu avoir quelques secondes de retard sans que personne ne le remarque, et ça aurait coûté bien moins cher.
Merci pour votre patience, et encore désolés si vous avez été touchés. Si vous avez des questions ou si vous avez remarqué quelque chose de bizarre ce jour-là, n’hésitez pas à nous écrire.
L’équipe PDFMonkey 🐒
Simon est passioné par le développement, la tech, le design et l’amélioration continue. CTO et Co-Fondateur chez PDFMonkey, il supervise le développement et l'évolution de la plateforme en s’assurant que le produit respecte toujours nos valeurs fondamentales.